Vector Database คืออะไร
Vector Database คือฐานข้อมูลที่ออกแบบมาเพื่อจัดเก็บ ค้นหา และประมวลผล เวกเตอร์ (Vector) ซึ่งเป็นข้อมูลในรูปแบบตัวเลขหลายมิติ เช่น [0.23, -0.87, 0.11, ..., 0.45] โดยเวกเตอร์เหล่านี้มักได้มาจากการแปลงข้อมูลที่ซับซ้อน เช่น ข้อความ รูปภาพ วิดีโอ หรือเสียง ให้อยู่ในรูปแบบตัวเลขที่สามารถนำมาเปรียบเทียบความคล้ายคลึงกันได้
Vector คืออะไร
ในโลกของ AI และ Machine Learning ข้อมูลเชิงซ้อน เช่น ข้อความหรือรูปภาพ จะถูกแปลงเป็นเวกเตอร์ด้วยโมเดลที่เรียกว่า Embedding Model เช่น BERT, CLIP หรือ Embedding API ต่าง ๆ เพื่อให้คอมพิวเตอร์สามารถคำนวณความสัมพันธ์ระหว่างข้อมูลได้
แนวคิดโดยทั่วไปคือ:
- ข้อความที่มีความหมายใกล้เคียงกัน มักมีตำแหน่งอยู่ใกล้กันใน Vector Space
- รูปภาพที่มีลักษณะคล้ายกัน มักมีเวกเตอร์ที่อยู่ใกล้กัน
- เราสามารถนำเวกเตอร์ของคำถามไปค้นหาเวกเตอร์ของเอกสารที่มีความหมายใกล้เคียงกันได้
Vector Database ใช้ทำอะไร?
- Retrieval-Augmented Generation(RAG) – แปลงเอกสารเป็น Embedding แล้วค้นหาส่วนที่เกี่ยวข้องกับคำถาม เพื่อนำไปใช้ประกอบการตอบคำถามด้วย LLM
- Semantic Search – ค้นหาข้อมูลจากความหมาย ไม่ใช่เพียงการค้นหาคำที่ตรงกัน เช่น ค้นคำว่า
dogแล้วพบเนื้อหาที่ใช้คำว่าpuppy - Recommendation System – แนะนำสินค้า เพลง หรือเนื้อหาที่มีลักษณะใกล้เคียงกับสิ่งที่ผู้ใช้สนใจ
- Image Search – ค้นหารูปภาพที่มีลักษณะคล้ายกับรูปภาพที่อัปโหลด
แนวทางการใช้งาน Vector Database มี 2 รูปแบบหลัก
การนำ Vector Search มาใช้ในระบบ สามารถแบ่งแนวทางเชิงสถาปัตยกรรมได้เป็น 2 กลุ่มใหญ่ ได้แก่ การใช้ฐานข้อมูลที่ออกแบบมาเพื่อจัดเก็บและค้นหาเวกเตอร์โดยเฉพาะ และการใช้ RDBMS ที่มีอยู่แล้วร่วมกับ Extension หรือส่วนเสริมที่เพิ่มความสามารถด้าน Vector Search
1. ใช้ Database ที่ออกแบบมาเป็น Vector Database โดยเฉพาะ
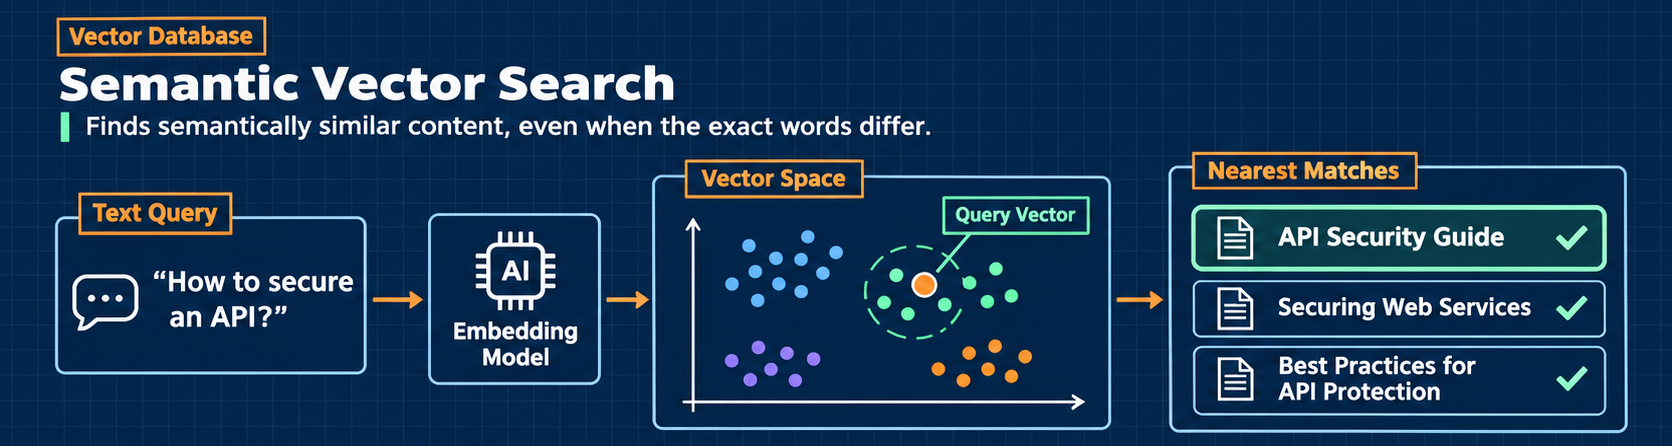
ฐานข้อมูลกลุ่มนี้ถูกออกแบบมาเพื่อจัดเก็บ Embedding และค้นหาเวกเตอร์ที่ใกล้เคียงกัน (Similarity Search / Nearest Neighbor Search) โดยตรง มักมี Index สำหรับ ANN, Metadata Filtering และความสามารถที่เหมาะกับงานค้นหาข้อมูลจำนวนมาก
ตัวอย่างการใช้งาน
สมมติว่าระบบมีเอกสารจำนวนหลายล้านรายการ และต้องการสร้างระบบค้นหาความรู้ (Knowledge Search) ให้ผู้ใช้ถามด้วยภาษาธรรมชาติ ระบบจะสร้าง Embedding ของเอกสารแล้วจัดเก็บลง Vector Database เมื่อผู้ใช้ส่งคำถาม ระบบจะสร้าง Query Embedding และค้นหาเอกสารที่มีเวกเตอร์ใกล้เคียงที่สุด จากนั้นส่งเนื้อหาที่ค้นพบให้ LLM ใช้ประกอบการตอบคำถาม
ตัวอย่างฐานข้อมูลที่นิยมใช้ 3 รายการ:
- Pinecone – Vector Database แบบ Managed Service เหมาะกับทีมที่ต้องการใช้งาน Vector Search โดยไม่ต้องดูแลโครงสร้างพื้นฐานของฐานข้อมูลเอง
- Milvus – Open-source Vector Database รองรับการติดตั้งแบบ Self-hosted และการขยายระบบสำหรับข้อมูลเวกเตอร์ขนาดใหญ่
- Qdrant – Open-source Vector Database ที่เน้น Vector Similarity Search และ Metadata Filtering มีทั้งแบบ Self-hosted และ Managed Cloud
ตัวอย่างภาพรวมการทำงาน
                 +------------------+
                 |   Embedding API  |
                 +--------+---------+
                          |
             Generate Embeddings
                          |
                          v
+-------------+   +--------------------+
| Application |-->| Dedicated Vector DB|
+-------------+   |                    |
       |          | - Vectors           |
       |          | - Metadata          |
       |          | - ANN Index         |
       |          +--------------------+
       |
       | User Query / Retrieved Context
       v
+-------------+
|     LLM     |
+-------------+
2. ใช้ RDBMS เดิม แล้วเพิ่ม Extension หรือส่วนเสริมสำหรับ Vector Search
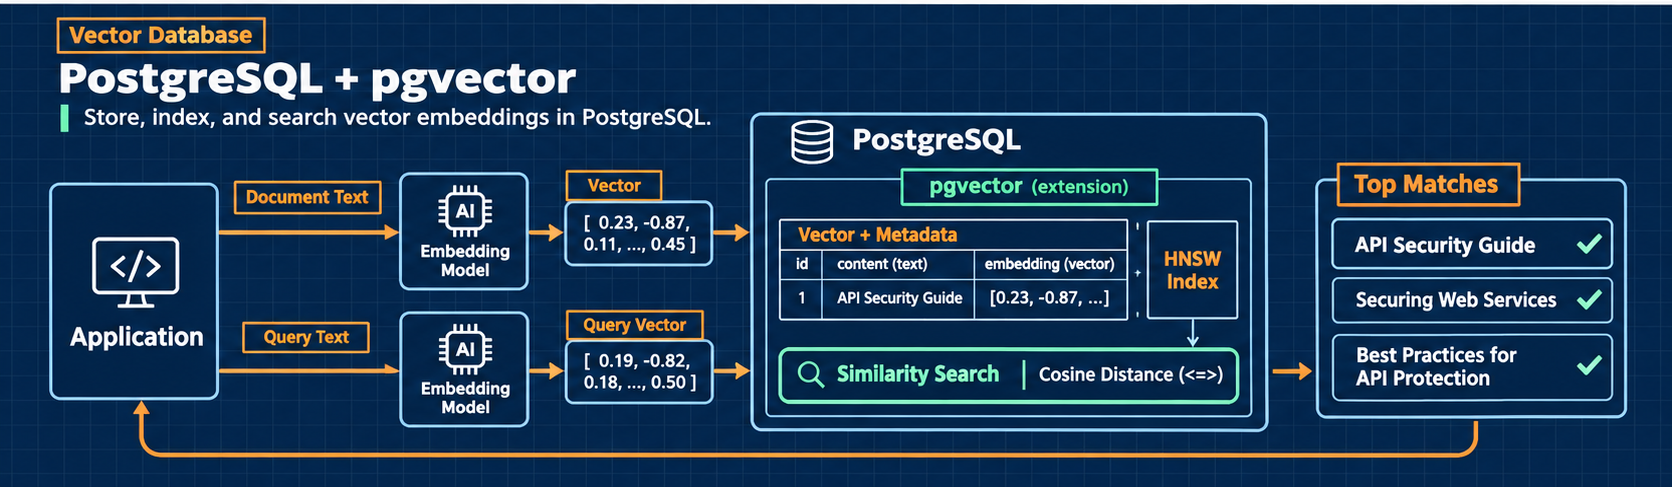
แนวทางนี้ใช้ฐานข้อมูลเชิงสัมพันธ์ (Relational Database Management System: RDBMS) ที่มีอยู่แล้ว เช่น PostgreSQL หรือ SQLite แล้วเพิ่ม Extension/Library ที่ช่วยจัดเก็บเวกเตอร์และค้นหาความคล้ายคลึงกัน
ข้อดีคือข้อมูลเชิงสัมพันธ์ เช่น ข้อมูลลูกค้า รายการสินค้า สิทธิ์การเข้าถึง และ Metadata สามารถจัดเก็บอยู่ในระบบเดียวกับ Embedding ได้ ทำให้ใช้ SQL, JOIN, Transaction และกลไกการดูแลข้อมูลเดิมร่วมกันได้
ตัวอย่างการใช้งาน
สมมติว่าระบบ E-commerce มี PostgreSQL สำหรับจัดเก็บสินค้าอยู่แล้ว ต้องการเพิ่มฟังก์ชันค้นหาสินค้าด้วยภาษาธรรมชาติ เช่น ผู้ใช้พิมพ์ว่า “รองเท้าสำหรับวิ่งระยะไกลที่รองรับแรงกระแทกดี”
ระบบจะสร้าง Embedding จากคำค้น แล้วใช้ pgvector ค้นหาสินค้าที่มีความหมายใกล้เคียงกัน โดยสามารถกรองข้อมูลด้วย SQL เพิ่มเติม เช่น เฉพาะสินค้าที่มีสถานะพร้อมขาย หรืออยู่ในหมวดหมู่ที่กำหนด
ตัวอย่างฐานข้อมูลและส่วนเสริมที่นิยมใช้ 3 รายการ:
- PostgreSQL + pgvector – pgvector เป็น PostgreSQL Extension ที่เพิ่มชนิดข้อมูล
vector, Distance Operators และ Index สำหรับ Exact/Approximate Nearest Neighbor Search เหมาะกับระบบที่ใช้ PostgreSQL อยู่แล้ว - SQLite + sqlite-vec – sqlite-vec เป็น Extension สำหรับเพิ่ม Vector Search ให้ SQLite เหมาะกับแอปพลิเคชันขนาดเล็ก, Desktop, Mobile หรือ Edge ที่ต้องการเก็บข้อมูลไว้ในเครื่องโดยไม่ต้องติดตั้ง Vector Database Server แยกต่างหาก
- YugabyteDB + pgvector – YugabyteDB เป็น Distributed SQL RDBMS ที่รองรับ PostgreSQL-compatible API และมี pgvector สำหรับจัดเก็บและค้นหาเวกเตอร์ เหมาะกับระบบที่ต้องการ SQL และการกระจายข้อมูลข้ามหลายโหนด ทั้งนี้การรองรับ Index และความสามารถบางอย่างอาจแตกต่างจาก PostgreSQL ต้นฉบับ
ตัวอย่างการใช้งาน PostgreSQL + pgvector
เริ่มจากติดตั้งหรือเตรียม PostgreSQL ที่รองรับ pgvector จากนั้นเปิดใช้งาน Extension
CREATE EXTENSION IF NOT EXISTS vector;
สร้างตารางสินค้า โดยเก็บทั้งข้อมูลเชิงสัมพันธ์และ Embedding ไว้ด้วยกัน
CREATE TABLE products (
    id BIGSERIAL PRIMARY KEY,
    name TEXT NOT NULL,
    category TEXT,
    price NUMERIC(10, 2),
    in_stock BOOLEAN DEFAULT TRUE,
    embedding VECTOR(3)
);
เพิ่มข้อมูลตัวอย่าง โดยเวกเตอร์ 3 มิติต่อไปนี้เป็นค่าจำลองเพื่อสาธิต SQL เท่านั้น ไม่ใช่ Embedding จากโมเดลจริง
INSERT INTO products (name, category, price, in_stock, embedding)
VALUES
('Running Shoe A', 'shoes', 2500, TRUE, '[0.10, 0.80, 0.20]'),
('Hiking Shoe B', 'shoes', 3200, TRUE, '[0.70, 0.20, 0.30]'),
('Running Shirt C', 'clothing', 900, TRUE, '[0.15, 0.75, 0.25]');
ค้นหาสินค้าที่มีความหมายใกล้เคียงกับ Query Vector พร้อมใช้ SQL Filter ตรวจสอบสถานะสินค้า
SELECT
    id,
    name,
    category,
    price,
    embedding <=> '[0.12, 0.78, 0.22]' AS distance
FROM products
WHERE in_stock = TRUE
ORDER BY embedding <=> '[0.12, 0.78, 0.22]'
LIMIT 5;
จุดสำคัญของแนวทางนี้คือ Vector Search สามารถทำงานร่วมกับเงื่อนไข SQL ปกติได้ เช่น WHERE, JOIN และการควบคุม Transaction โดยไม่ต้องส่งข้อมูลไปค้นหาในฐานข้อมูลอีกระบบหนึ่ง
หมายเหตุ: ตัวอย่าง RDBMS ข้างต้นไม่ได้หมายความว่าทุกผลิตภัณฑ์ใช้ Extension แบบเดียวกันทั้งหมด โดย pgvector และ sqlite-vec เป็นส่วนเสริมของ PostgreSQL และ SQLite ตามลำดับ ส่วน YugabyteDB มี pgvector ที่รองรับใน YSQL ทั้งนี้ MariaDB 11.7 ขึ้นไปก็มี Vector Search เช่นกัน แต่เป็นความสามารถที่ติดตั้งมาในตัว (Native) ไม่ใช่ Plugin หรือ Extension จึงไม่ได้นำมาจัดอยู่ในตัวอย่างกลุ่มนี้
เปรียบเทียบ Vector Database โดยเฉพาะ กับ RDBMS ที่เพิ่ม Vector Extension
| ประเด็น | Dedicated Vector Database | RDBMS + Vector Extension |
|---|---|---|
| จุดประสงค์หลัก | ออกแบบมาเพื่อ Vector Search โดยเฉพาะ | ฐานข้อมูลทั่วไปที่เพิ่มความสามารถ Vector Search |
| การจัดเก็บข้อมูล | เน้น Embedding และ Metadata ที่เกี่ยวข้อง | เก็บข้อมูล Relational และ Embedding ร่วมกัน |
| การค้นหา | มี Vector Index และ ANN เป็นความสามารถหลัก | ขึ้นอยู่กับ Extension และความสามารถของแต่ละระบบ |
| SQL และ JOIN | ขึ้นอยู่กับระบบและ Query API ที่รองรับ | ใช้ SQL และ JOIN กับตารางเดิมได้ |
| การดูแลระบบ | อาจต้องดูแลระบบฐานข้อมูลเพิ่มอีกชุดหนึ่ง | ใช้ระบบฐานข้อมูลเดิม ลดจำนวนระบบที่ต้องดูแล |
| การขยายระบบ | หลายผลิตภัณฑ์ออกแบบมารองรับ Vector Workload ขนาดใหญ่ | ขึ้นอยู่กับ RDBMS, Extension และรูปแบบการติดตั้ง |
| เหมาะกับ | ระบบค้นหาเวกเตอร์เป็นงานหลัก หรือมี Vector Workload ขนาดใหญ่ | ระบบที่มี RDBMS อยู่แล้วและต้องการเพิ่ม Semantic Search หรือ RAG |
ควรเลือกใช้แนวทางไหนดี?
เลือก Dedicated Vector Database เมื่อ:
- ระบบมีข้อมูล Embedding จำนวนมากและ Vector Search เป็น Workload หลัก
- ต้องการความสามารถด้าน Vector Indexing, Filtering หรือ Hybrid Search ที่ออกแบบมาเฉพาะ
- ต้องการแยกการขยายทรัพยากรของ Vector Search ออกจากฐานข้อมูลธุรกรรม
- ทีมพร้อมดูแลฐานข้อมูลอีกระบบหนึ่ง หรือเลือกใช้ Managed Service
เลือก RDBMS + Vector Extension เมื่อ:
- ระบบมี PostgreSQL หรือ RDBMS ที่รองรับอยู่แล้ว
- ต้องการเก็บ Embedding ไว้ใกล้กับข้อมูลธุรกิจ เช่น ลูกค้า สินค้า และเอกสาร
- ต้องการใช้ SQL, JOIN, Transaction และระบบ Backup/Access Control ที่มีอยู่
- ต้องการลดความซับซ้อนและจำนวนระบบที่ต้องดูแล
ไม่มีแนวทางใดดีกว่าเสมอไป ควรพิจารณาจากปริมาณข้อมูล จำนวนคำค้นต่อวินาที ความหน่วงที่ยอมรับได้ ความซับซ้อนของ Metadata Filtering และความสามารถในการดูแลระบบของทีม
จุดเด่นของ Vector Database
- รองรับการค้นหา Nearest Neighbor เพื่อค้นหาเวกเตอร์ที่อยู่ใกล้กับเวกเตอร์เป้าหมาย
- รองรับการค้นหาแบบ Approximate Nearest Neighbor (ANN) เพื่อแลกเปลี่ยนความแม่นยำบางส่วนกับความเร็วในการค้นหา
- สามารถทำงานร่วมกับ AI และ Large Language Models (LLMs) ได้ดี เช่น ระบบ RAG (Retrieval-Augmented Generation)
ใช้ PostgreSQL เป็น Vector Database ด้วย pgvector
นอกจากการใช้ Vector Database โดยเฉพาะแล้ว เรายังสามารถใช้ PostgreSQL ที่มี Extension ชื่อ pgvector เพื่อจัดเก็บและค้นหาเวกเตอร์ได้ด้วย
pgvector เพิ่มชนิดข้อมูล vector และ Operator สำหรับคำนวณระยะห่างระหว่างเวกเตอร์ ทำให้เราสามารถจัดเก็บข้อมูลทั่วไป เช่น ข้อความและ Metadata พร้อมกับ Embedding ไว้ในฐานข้อมูลเดียวกันได้
ข้อดีของแนวทางนี้คือ แอปพลิเคชันยังใช้ความสามารถของ PostgreSQL ได้ตามปกติ เช่น SQL, JOIN, Transaction, Index และการจัดการสิทธิ์ โดยไม่จำเป็นต้องดูแลฐานข้อมูลอีกระบบหนึ่งสำหรับ Vector Search
1. ติดตั้ง PostgreSQL พร้อม pgvector ด้วย Docker Compose
สร้างไฟล์ compose.yaml ดังนี้
services:
  postgres:
    image: pgvector/pgvector:pg17-trixie
    container_name: postgres-pgvector
    environment:
      POSTGRES_DB: vectordb
      POSTGRES_USER: app
      POSTGRES_PASSWORD: secret
    ports:
      - "5432:5432"
    volumes:
      - postgres_data:/var/lib/postgresql/data

volumes:
  postgres_data:
เริ่มต้น Container ด้วยคำสั่ง
docker compose up -d
เชื่อมต่อเข้า PostgreSQL
docker exec -it postgres-pgvector psql -U app -d vectordb
ตัวอย่างนี้ใช้ Image ของ pgvector สำหรับ PostgreSQL 17 หากต้องการใช้ PostgreSQL เวอร์ชันอื่น ให้เลือก Image Tag ที่ตรงกับเวอร์ชันนั้น
2. เปิดใช้งาน pgvector Extension
เมื่อเชื่อมต่อเข้า Database แล้ว ให้เปิดใช้งาน Extension
CREATE EXTENSION IF NOT EXISTS vector;
ตรวจสอบ Extension ที่ติดตั้งแล้ว
\dx
3. สร้างตารางสำหรับจัดเก็บข้อมูลและ Embedding
ตัวอย่างนี้จะสร้างตาราง documents เพื่อจัดเก็บข้อความและเวกเตอร์ที่ได้จาก Embedding Model
CREATE TABLE documents (
    id BIGSERIAL PRIMARY KEY,
    content TEXT NOT NULL,
    embedding VECTOR(3)
);
VECTOR(3) หมายถึงเวกเตอร์ที่มีตัวเลข 3 มิติ ในตัวอย่างนี้ใช้เพียง 3 มิติเพื่อให้อ่านและทดลองได้ง่าย
ในระบบจริงต้องกำหนดจำนวนมิติให้ตรงกับผลลัพธ์จาก Embedding Model ที่เลือกใช้ เช่น หากโมเดลสร้างเวกเตอร์ 1,536 มิติ ต้องกำหนดคอลัมน์เป็น VECTOR(1536) และทุกเวกเตอร์ที่บันทึกต้องมีจำนวนมิติตรงกัน
4. เพิ่มข้อมูลตัวอย่าง
โดยปกติแอปพลิเคชันจะส่งข้อความไปยัง Embedding Model เพื่อสร้างเวกเตอร์ก่อน แล้วจึงบันทึกข้อความและเวกเตอร์ลง PostgreSQL
เพื่อให้ทดลอง SQL ได้โดยไม่ต้องเรียก Embedding API เราจะกำหนดเวกเตอร์ตัวอย่างขึ้นมาเอง
INSERT INTO documents (content, embedding) VALUES
(
    'PostgreSQL is a relational database',
    '[0.10, 0.90, 0.20]'
),
(
    'pgvector enables vector similarity search',
    '[0.12, 0.85, 0.18]'
),
(
    'Docker is used to package applications',
    '[0.80, 0.10, 0.20]'
),
(
    'Kubernetes manages container workloads',
    '[0.75, 0.15, 0.25]'
),
(
    'Machine learning models generate embeddings',
    '[0.15, 0.80, 0.30]'
);
เวกเตอร์ในตัวอย่างเป็นข้อมูลสมมติ ไม่ใช่ Embedding ที่สร้างจากโมเดลจริง ดังนั้นจึงเหมาะสำหรับทดลองการทำงานของ SQL และ Similarity Search เท่านั้น
5. ค้นหาข้อมูลด้วย Similarity Search
สมมติว่าแอปพลิเคชันแปลงคำถามของผู้ใช้เป็น Query Vector แล้วได้ค่า
[0.11, 0.88, 0.19]
เราสามารถค้นหาเอกสารที่มีเวกเตอร์ใกล้เคียงกับ Query Vector ได้ด้วย Cosine Distance Operator (<=>)
SELECT
    id,
    content,
    embedding <=> '[0.11, 0.88, 0.19]' AS distance
FROM documents
ORDER BY distance
LIMIT 3;
ผลลัพธ์จะเรียงจาก Distance น้อยไปมาก หมายถึงเวกเตอร์ที่อยู่ใกล้กับ Query Vector มากที่สุดจะอยู่ลำดับแรก
หากต้องการแสดงค่า Cosine Similarity แทน Cosine Distance สามารถคำนวณได้ดังนี้
SELECT
    id,
    content,
    1 - (embedding <=> '[0.11, 0.88, 0.19]') AS similarity
FROM documents
ORDER BY embedding <=> '[0.11, 0.88, 0.19]'
LIMIT 3;
ค่า Similarity ที่สูงขึ้นหมายถึงมีความใกล้เคียงกันมากขึ้นสำหรับ Cosine Similarity ทั้งนี้ไม่ควรตีความเป็นเปอร์เซ็นต์ความถูกต้องของคำตอบ
6. Distance Operators ที่ pgvector รองรับ
pgvector มี Operator หลายรูปแบบสำหรับคำนวณระยะห่างหรือความสัมพันธ์ระหว่างเวกเตอร์
| Operator | ความหมาย |
|---|---|
<-> |
L2 distance (Euclidean distance) |
<#> |
Negative inner product |
<=> |
Cosine distance |
<+> |
L1 distance (Manhattan distance) |
<~> |
Hamming distance สำหรับ Binary Vector |
<%> |
Jaccard distance สำหรับ Binary Vector |
การเลือก Operator ขึ้นอยู่กับลักษณะของ Embedding และวิธีวัดความคล้ายคลึงที่ต้องการ ในตัวอย่างนี้เลือกใช้ Cosine Distance (<=>) เพื่อสาธิต Semantic Search
7. เพิ่มประสิทธิภาพการค้นหาด้วย HNSW Index
โดยค่าเริ่มต้น pgvector จะค้นหาแบบ Exact Nearest Neighbor ซึ่งให้ผลการค้นหาครบถ้วน แต่เมื่อจำนวนเวกเตอร์เพิ่มขึ้น การค้นหาอาจใช้เวลามากขึ้น
เราสามารถสร้าง Index เพื่อใช้ Approximate Nearest Neighbor (ANN) ได้ โดย pgvector รองรับ HNSW และ IVFFlat
ตัวอย่างการสร้าง HNSW Index สำหรับ Cosine Distance
CREATE INDEX documents_embedding_hnsw_idx
ON documents
USING hnsw (embedding vector_cosine_ops);
เมื่อสร้าง Index แล้ว คำสั่งค้นหาสามารถใช้รูปแบบเดิมได้
SELECT
    id,
    content,
    embedding <=> '[0.11, 0.88, 0.19]' AS distance
FROM documents
ORDER BY embedding <=> '[0.11, 0.88, 0.19]'
LIMIT 3;
HNSW เป็น Index ที่ช่วยเพิ่มความเร็วในการค้นหา โดยแลกกับโอกาสที่ผลลัพธ์อาจไม่ตรงกับ Exact Search ทุกประการ นอกจากนี้ยังใช้หน่วยความจำและเวลาในการสร้าง Index มากกว่าแนวทางบางชนิด
สำหรับข้อมูลขนาดเล็ก การค้นหาแบบ Exact อาจเพียงพอแล้ว ควรทดสอบด้วยข้อมูลจริงและตรวจสอบแผนการทำงานด้วย EXPLAIN (ANALYZE, BUFFERS) ก่อนตัดสินใจเลือก Index
8. ตัวอย่างการนำ pgvector ไปใช้กับ RAG
pgvector สามารถเป็นส่วนหนึ่งของระบบ RAG (Retrieval-Augmented Generation) ได้ โดยมีขั้นตอนการทำงานดังนี้
- Document Ingestion – นำเอกสารมาแบ่งเป็น Chunk ตามขนาดที่เหมาะสม
- Generate Embedding – ส่งแต่ละ Chunk ไปยัง Embedding Model เพื่อสร้างเวกเตอร์
- Store – บันทึกข้อความ, Metadata และ Embedding ลง PostgreSQL
- User Query – รับคำถามจากผู้ใช้และสร้าง Query Embedding ด้วยโมเดลเดียวกัน
- Similarity Search – ใช้ pgvector ค้นหา Chunk ที่มีความใกล้เคียงกับคำถาม
- Generate Answer – ส่งคำถามและเนื้อหาที่ค้นพบไปให้ LLM สร้างคำตอบ
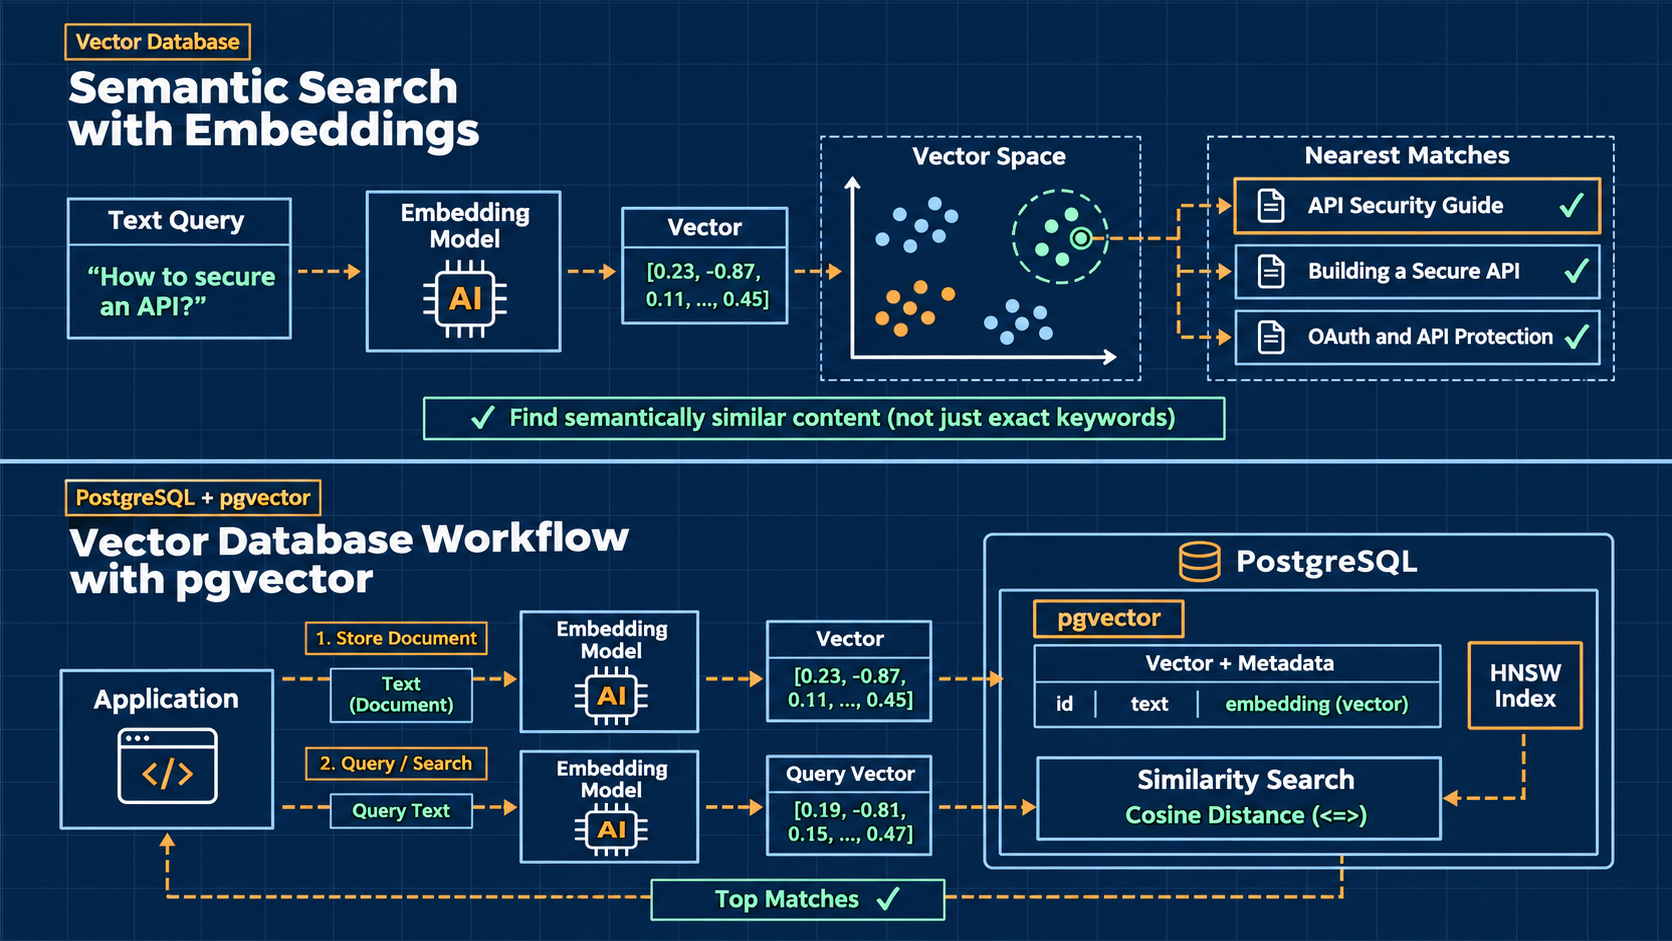
ตัวอย่าง SQL สำหรับค้นหา Chunk ที่เกี่ยวข้องกับคำถาม สามารถนำผลลัพธ์ไปเป็น Context ให้ LLM ได้
SELECT
    content,
    embedding <=> '[0.11, 0.88, 0.19]' AS distance
FROM documents
ORDER BY embedding <=> '[0.11, 0.88, 0.19]'
LIMIT 5;
ข้อควรจำคือ pgvector ทำหน้าที่จัดเก็บเวกเตอร์และค้นหาข้อมูลที่ใกล้เคียงกัน ส่วนการสร้าง Embedding และการสร้างคำตอบยังเป็นหน้าที่ของ Embedding Model และ LLM ตามลำดับ
สรุป
Vector Database เป็นองค์ประกอบสำคัญสำหรับแอปพลิเคชัน AI ที่ต้องค้นหาข้อมูลจากความหมายหรือความคล้ายคลึงกัน ไม่ใช่เพียงการค้นหาคำที่ตรงกันเท่านั้น
หากระบบใช้งาน PostgreSQL อยู่แล้ว pgvector เป็นทางเลือกที่น่าสนใจ เพราะช่วยให้สามารถจัดเก็บข้อมูลทั่วไปและ Embedding ไว้ในฐานข้อมูลเดียวกัน พร้อมรองรับ Similarity Search และ ANN Index อย่าง HNSW ได้
อย่างไรก็ตาม หากระบบมีข้อมูลเวกเตอร์จำนวนมาก มีรูปแบบการค้นหาซับซ้อน หรือต้องการความสามารถเฉพาะทาง การเลือกใช้ Vector Database โดยเฉพาะก็อาจเหมาะสมกว่า ขึ้นอยู่กับ Workload และข้อกำหนดของระบบ